

1. Introduction
La surveillance acoustique des milieux naturels est devenue un outil essentiel pour la recherche écologique, la prévention des catastrophes et la conservation de la faune. Les écosystèmes montagneux, en particulier, sont soumis à des conditions environnementales qui évoluent rapidement, notamment les impacts de foudre, les feux de forêt et les phénomènes météorologiques extrêmes, qui présentent des risques importants pour la sécurité humaine et la biodiversité. Les approches de surveillance traditionnelles reposent sur des réseaux de capteurs spécialisés avec traitement centralisé des données, ce qui introduit de la latence, des coûts d’infrastructure et des points uniques de défaillance. Les systèmes d’apprentissage automatique déployables en périphérie offrent une solution de rechange intéressante : des modèles légers capables de fonctionner en continu sur du matériel aux ressources limitées, sans dépendance au réseau.
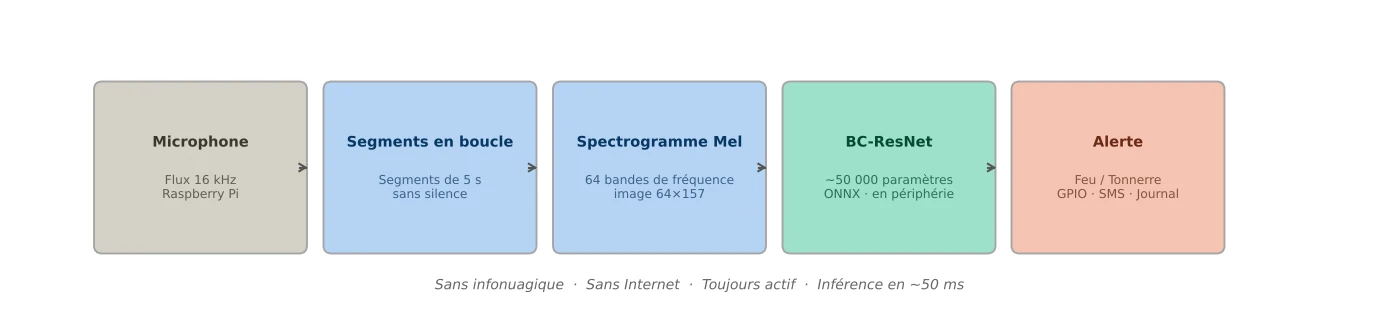
Ce projet développe et évalue un système intégré de surveillance et de prévision acoustiques (IAMPS) visant deux tâches principales de détection : la détection de la foudre et du tonnerre à partir de signatures acoustiques, et l’infrastructure de classification de base pour la surveillance de la biodiversité par l’identification des vocalisations animales. Le système est conçu comme un détecteur toujours actif de type détection de mots-clés (KWS), dont l’architecture et les contraintes sont analogues à celles des systèmes commerciaux de détection de mots d’activation, plutôt que comme une chaîne classique de classification des sons environnementaux (ESC) hors ligne.
Les principales questions de recherche abordées dans ces travaux sont les suivantes :
- Quelle stratégie d’extraction de caractéristiques représente le mieux les propriétés acoustiques des classes de sons environnementaux sous les contraintes d’un déploiement en périphérie?
- Quelle architecture de modèle léger offre le meilleur équilibre entre l’exactitude globale, le rappel par classe, particulièrement pour le tonnerre, et l’efficacité de calcul?
- La répétition audio en boucle comme stratégie de prétraitement peut-elle améliorer la performance des modèles par rapport au remplissage par des zéros pour la classification d’extraits de durée variable?
2. Contexte et travaux connexes
2.1 De l’ESC à l’IA en périphérie en continu : un changement de perspective
La revue initiale de la littérature portait sur la classification des sons environnementaux (ESC), qui a fourni des bases essentielles en représentation des caractéristiques, en architectures CNN et en méthodologie d’évaluation. Toutefois, un constat déterminant s’est dégagé : la recherche en ESC suppose implicitement des conditions qui ne s’appliquent pas à un système réel toujours actif. Les articles en ESC supposent généralement des extraits audio de durée fixe, une inférence hors ligne ou par lots, une décision de classification par extrait et l’exactitude comme mesure principale. Ces hypothèses ne tiennent plus dans l’application visée, où l’audio est continu et de durée indéfinie, les événements cibles sont rares, le système doit fonctionner 24 h/24, 7 j/7, les faux positifs s’accumulent avec le temps et les ressources matérielles et énergétiques sont strictement limitées.
Ce constat a motivé un recentrage du projet sur la littérature en détection de mots-clés (KWS), qui traite des enjeux à l’échelle du système laissés de côté par la recherche en ESC. Sur le plan structurel, la détection du tonnerre est analogue à celle d’un mot d’activation : un événement rare et acoustiquement distinctif doit être identifié de façon fiable dans un flux continu, avec un minimum de faux déclenchements. Ce changement de perspective a orienté toutes les décisions ultérieures d’architecture et de prétraitement.
2.2 Fondements de la classification des sons environnementaux
Piczak (2015) a présenté le jeu de données ESC-50 [20] et montré que les CNN 2D appliqués aux spectrogrammes log-mel surpassent les classificateurs traditionnels à caractéristiques conçues manuellement pour la classification des sons environnementaux, établissant ainsi le paradigme spectrogramme-CNN qui domine les travaux ultérieurs [1]. Salamon et Bello (2017) ont approfondi ce constat en montrant que les CNN profonds combinés à l’augmentation de données audio atteignent des performances de pointe sur UrbanSound8K, même lorsque les données étiquetées sont limitées [2]. Leurs travaux motivent directement l’utilisation des caractéristiques de spectrogrammes mel comme représentation principale dans ce projet.
Mushtaq et Su (2020) ont comparé systématiquement les architectures CNN et les représentations de caractéristiques sur ESC-10, ESC-50 et UrbanSound8K. Ils ont constaté que les CNN sans regroupement maximal, utilisant des caractéristiques log-mel et une augmentation des données hors ligne, obtiennent les meilleurs résultats : 94,94 % sur ESC-10 et 89,28 % sur ESC-50 [3]. Leurs travaux confirment que la conception des caractéristiques et les choix de régularisation ont souvent plus d’effet que la complexité de l’architecture.
Li et ses collaborateurs (2017) ont comparé l’apprentissage profond et les approches traditionnelles de détection des sons environnementaux sur le jeu de données DCASE 2016. Ils ont constaté que la fusion tardive de modèles complémentaires donne les meilleurs résultats, avec une exactitude d’environ 88 %, et qu’aucun modèle ne domine pour tous les types de caractéristiques [4]. Ce constat a motivé la décision d’évaluer plusieurs architectures plutôt que de s’en tenir à une seule famille de modèles.
Zhang et ses collaborateurs (2017) ont proposé des réseaux neuronaux à convolutions dilatées pour l’ESC, montrant que ces convolutions captent le contexte temporel à longue portée plus efficacement que des CNN standard plus profonds, tout en conservant une complexité de calcul comparable [5]. Leurs travaux atteignent 81,9 % sur UrbanSound8K et motivent la prise en compte de la conception du champ récepteur dans notre sélection d’architectures.
2.3 Surveillance bioacoustique
Pour le volet de surveillance de la biodiversité, plusieurs travaux propres à la bioacoustique ont été examinés. Kahl et ses collaborateurs (2021) ont développé BirdNET, un CNN profond atteignant une moyenne des précisions moyennes de 0,791 pour la classification des espèces d’oiseaux dans des paysages sonores réels. Ils ont ainsi montré que les données d’entraînement propres au domaine et les stratégies d’augmentation sont essentielles à une performance robuste en milieu naturel [6]. Silva et ses collaborateurs (2022) ont présenté soundClass, une chaîne CNN de type VGG d’environ 360 000 paramètres pour la surveillance acoustique passive de la biodiversité. Elle atteint un score F1 de 87 % pour la classification des cris de chauves-souris et souligne que la facilité d’utilisation et l’accessibilité sont aussi importantes que l’exactitude du modèle pour un déploiement en écologie [7].
Stowell et ses collaborateurs (2019) ont montré que la performance d’identification acoustique diminue considérablement lorsque les conditions d’enregistrement diffèrent entre les données d’entraînement et de test, soulignant l’importance de l’adaptation de domaine et de la robustesse au bruit pour les systèmes déployés sur le terrain [8]. Ce constat est directement pertinent pour l’application visée, où des modèles entraînés sur des jeux de données soigneusement sélectionnés seront déployés dans des milieux extérieurs non contrôlés.
2.4 Détection de mots-clés et inférence en continu
Kim et ses collaborateurs (2021) ont présenté BC-ResNet (Broadcasting-Residual Network), qui atteint une exactitude de pointe sur Google Speech Commands avec moins de 10 000 paramètres dans sa plus petite variante : BC-ResNet-1 obtient 96,6 % sur la version 1 [9]. Le mécanisme de diffusion combine des convolutions temporelles 1D et fréquentielles-temporelles 2D au moyen d’une connexion résiduelle qui redéploie les caractéristiques temporelles dans l’espace fréquentiel-temporel 2D, réduisant le calcul tout en préservant la structure spectrale. Cette architecture a directement inspiré le CNN 2D utilisé dans ces travaux.
Majumdar et Ginsburg (2020) ont proposé MatchboxNet, une architecture à convolutions 1D séparables selon le temps et les canaux pour la reconnaissance de commandes vocales. Elle atteint 97,48 % sur Google Speech Commands v1 avec seulement 93 000 paramètres [10]. Leurs travaux montrent que traiter la dimension fréquentielle comme des canaux et le temps comme une séquence 1D constitue un biais inductif très économe en paramètres pour la classification audio. MatchboxNet a été retenu comme deuxième architecture candidate pour cette raison.
Rybakov et ses collaborateurs (2020) ont réalisé une évaluation comparative systématique de la détection de mots-clés en continu sur des appareils mobiles, montrant que SVDF, les modèles à GRU et les CNN à convolutions séparables en profondeur offrent les meilleurs compromis entre exactitude et latence pour l’inférence en continu en temps réel [11]. Leurs travaux établissent que les modèles GRU, bien que théoriquement intéressants pour la modélisation temporelle, entraînent un surcoût d’inférence important par rapport aux approches fondées sur les CNN, un constat cohérent avec les résultats de cette étude.
2.5 Systèmes en périphérie en production
Trois systèmes de déclenchement vocal exploités à grande échelle ont été examinés pour comprendre les contraintes de déploiement réelles. Sigtia et ses collaborateurs (2018) ont décrit le système de détection « Hey Siri » d’Apple, montrant qu’un traitement MFCC à faible fréquence de trames, environ 16 par seconde, combiné à une modélisation de la durée peut offrir un rappel élevé avec une très faible consommation d’énergie [12]. Le constat principal, selon lequel la cohérence temporelle entre les trames importe davantage que les détails spectraux fins, s’applique directement à la détection du tonnerre, où l’enveloppe temporelle caractéristique d’un coup de tonnerre est plus informative sur le plan diagnostique que le contenu fréquentiel précis.
L’approche d’Amazon pour la détection des limites des mots d’activation (2019) a montré que l’estimation des probabilités par trame à l’aide de CNN permet de localiser précisément le début et la fin des événements sans décodage par modèle de Markov caché (HMM), ce qui rend les systèmes embarqués plus simples et réduit leur latence [13]. L’évaluation comparative de Rybakov et de ses collaborateurs sur la KWS en continu a également confirmé que la conversion automatique des modèles entraînés à l’inférence en continu, au moyen d’une mise en mémoire tampon des états, réduit la latence d’un facteur de 10 à 20 par rapport aux approches non continues [11].
Ces systèmes de production ont collectivement motivé la conception de la chaîne IAMPS inspirée de la KWS, notamment la stratégie d’inférence par fenêtre glissante et la priorité accordée au taux de faux positifs, en plus du rappel, comme mesures d’évaluation.
2.6 Inventaire des jeux de données
Un inventaire complet des jeux de données audio disponibles a été réalisé afin de repérer des sources de données appropriées. Les principaux jeux de données envisagés sont résumés ci-dessous :
| Jeu de données | Taille | Classes | Licence | Retenu |
|---|---|---|---|---|
| ESC-50 | 2 000 extraits (5 s) | 50 | CC BY-NC-SA 4.0 | Oui |
| FSD50K | Grande | 200 | Licences CC diverses | Oui |
| UrbanSound8K | 8 732 extraits | 10 | CC BY-NC | Non |
| DCASE 2016/17 | Environ 13 à 17 h | Scènes | Recherche | Non |
| BirdCLEF | Des millions | Espèces d’oiseaux | CC BY-NC | Travaux futurs |
| Xeno-Canto | 700 000+ | Espèces d’oiseaux | CC BY-NC | Travaux futurs |
| Google Speech Cmds | Environ 65 000 extraits | 35 mots | CC BY 4.0 | Non |
| AudioSet | 2 millions d’extraits (10 s) | 527 | Recherche uniquement | Non |
2.7 Inventaire des modèles candidats
Avant la mise en œuvre, un vaste inventaire des architectures candidates a été réalisé dans la littérature en ESC et en KWS. Les modèles ont été évalués selon quatre critères : l’exactitude sur les jeux de données de référence, le nombre de paramètres, la latence d’inférence sur du matériel en périphérie et l’adéquation au déploiement en continu.
| Modèle | Paramètres | Exactitude | Adapté à la périphérie | Retenu |
|---|---|---|---|---|
| BC-ResNet-1 | 9 000 | 96,6 % (GSC v1) | Oui | Oui (adapté) |
| MatchboxNet-3x2x64 | 93 000 | 97,48 % (GSC v1) | Oui | Oui |
| TC-ResNet14-1.5 | 305 000 | 96,6 % | Oui | Non (plus volumineux) |
| DS-CNN-L | 250 000 | 95,6 % | À la limite | Non |
| GRU (de type KWS) | Environ 200 000 | 93–95 % | Non | Oui (référence) |
| CRNN (de type DCASE) | Environ 230 000 | 95–96 % | Non | Non |
| LSTM | Environ 300 000 | 94–96 % | Non | Non |
| SVDF | 10 000–50 000 | 90–94 % | Oui | Non (exactitude inférieure) |
| BirdNET | Modérée | mAP de 0,791 | À la limite | Non (biodiversité) |
3. Jeu de données
3.1 Sources de données
Le jeu de données a été constitué à partir de trois sources :
- ESC-50 : Un jeu de données de référence comprenant 2 000 extraits de sons environnementaux répartis en 50 classes, chacun d’une durée de 5 secondes, provenant de Freesound et annotés par des personnes à l’écoute [20]. Six classes pertinentes ont été retenues.
- FSD50K : Un jeu de données audio à grande échelle provenant de Freesound, avec des étiquettes faibles réparties en 200 classes sonores [21]. Les extraits pertinents pour les six classes cibles ont été sélectionnés.
- FireDataset : Un jeu de données personnalisé d’enregistrements audio de feu, constitué pour enrichir la classe Feu, fortement sous-représentée dans les jeux de référence publics par rapport à son importance dans l’application visée.
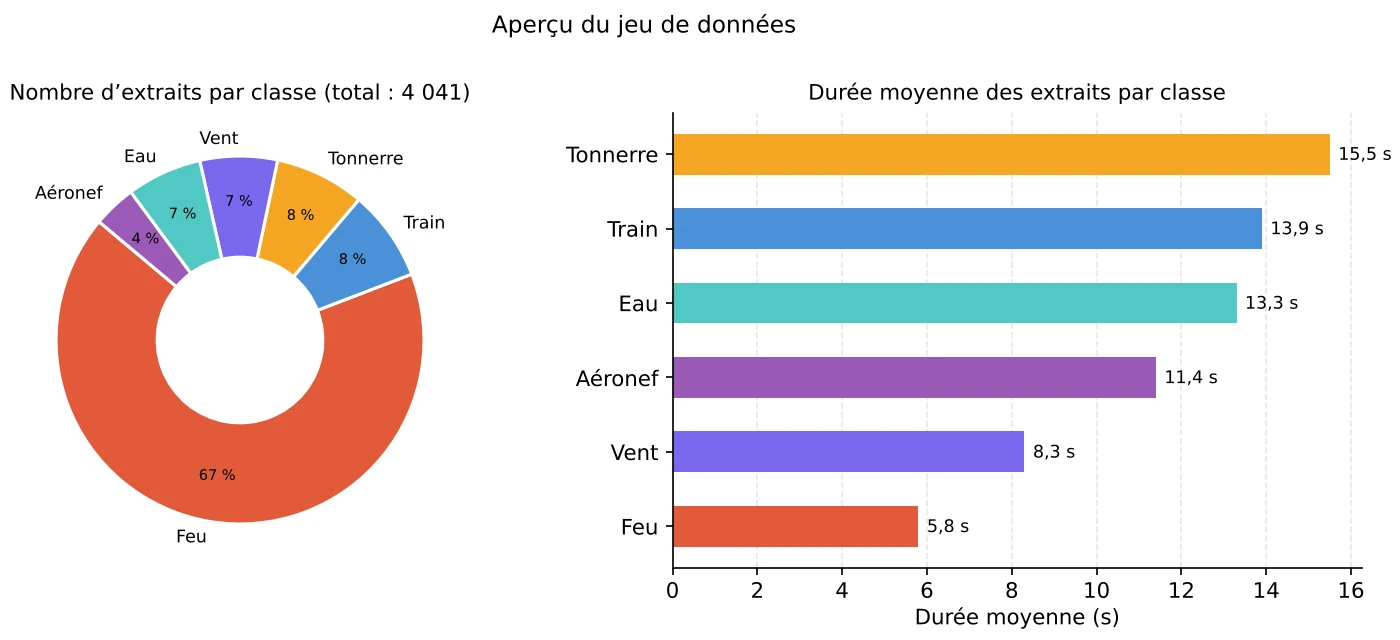
Le jeu de données combiné contient 4 041 extraits audio répartis en six classes : Aéronef, Feu, Tonnerre, Train, Eau et Vent.
3.2 Répartition et déséquilibre des classes
Le jeu de données présente un déséquilibre important entre les classes. La classe Feu compte 2 708 extraits, soit 67 % du total, tandis que la plus petite classe, Aéronef, n’en contient que 151, soit 3,7 %. Les autres classes, Train (323), Tonnerre (318), Vent (273) et Eau (268), sont modérément représentées.
| Classe | Extraits | Durée moyenne (s) | Durée totale (min) |
|---|---|---|---|
| Feu | 2 708 | 5,8 | 261,8 |
| Train | 323 | 13,9 | 74,7 |
| Tonnerre | 318 | 15,5 | 82,0 |
| Vent | 273 | 8,3 | 37,8 |
| Eau | 268 | 13,3 | 59,4 |
| Aéronef | 151 | 11,4 | 28,7 |
Pour limiter la dominance de la classe Feu, le nombre d’échantillons de cette classe a été plafonné à 300 dans les expériences avec remplissage ou troncature, et à 1 000 dans les expériences avec segmentation, avant la répartition entre les ensembles d’entraînement, de validation et de test. Cette mesure empêche le déséquilibre des classes de se propager aux trois sous-ensembles.
3.3 Analyse de la durée
La durée des extraits varie de 0,33 à 30 secondes, avec une moyenne de 8,1 secondes et un écart-type de 6,4 secondes. Les extraits de la classe Tonnerre présentent la durée moyenne la plus longue, soit 15,5 secondes, et 75 % dépassent 22 secondes. Ce constat est particulièrement important pour la conception de l’extraction de caractéristiques : les approches de référence limitées à 9,6 secondes tronquent la majorité du contenu des extraits de tonnerre.
4. Extraction de caractéristiques
Tout l’audio a été rééchantillonné à 16 000 Hz avant l’extraction de caractéristiques. Quatre approches ont été évaluées.
4.1 Approche 1 : spectrogramme mel, 9,6 secondes (référence)
Les spectrogrammes mel ont été calculés avec librosa, à l’aide de 64 bandes de fréquences et d’un pas de 512 échantillons. Les caractéristiques ont été fixées à 300 trames temporelles, soit environ 9,6 secondes d’audio : T = (300 × 512) / 16000 = 9,6 secondes. Les extraits de moins de 9,6 secondes ont été complétés par des zéros; les plus longs ont été tronqués. La couverture de 9,6 secondes découlait implicitement du nombre de trames choisi plutôt que d’une décision de conception délibérée, ce qui a entraîné une troncature importante des extraits de tonnerre et de train. Dimensions de sortie : (64, 300).
4.2 Approche 2 : spectrogramme mel et MFCC, 30 secondes
L’analyse de la matrice de confusion du modèle de référence a révélé des erreurs de classification récurrentes entre Feu et Vent. Ces deux classes produisent un bruit continu et non tonal dont les distributions d’énergie spectrale sont semblables, ce qui les rend difficiles à distinguer au moyen des seules caractéristiques du spectrogramme mel. Des coefficients cepstraux en fréquences mel (MFCC) ont été ajoutés comme caractéristiques complémentaires afin de fournir une empreinte texturale compacte de l’enveloppe spectrale.
La couverture a été étendue à 30 secondes, soit 938 trames, pour saisir tout le contenu temporel des extraits plus longs : T = (938 × 512) / 16000 ≈ 30 secondes. Les caractéristiques MFCC, soit 40 coefficients, ont été calculées avec le même pas, puis empilées verticalement sous le spectrogramme mel pour produire une carte de caractéristiques combinée de dimensions (104, 938). Bien que cette configuration ait amélioré l’exactitude globale de classification, elle a réduit le rappel du tonnerre, probablement parce que la compression par transformée en cosinus discrète (DCT) des MFCC atténue l’énergie impulsive abrupte caractéristique des coups de tonnerre. Dimensions de sortie : (104, 938).
4.3 Approche 3 : segments de spectrogramme mel, 5 secondes avec remplissage par des zéros
Plutôt que de représenter chaque extrait par une seule caractéristique de durée fixe, l’audio a été divisé en segments de 5 secondes sans chevauchement. Tout segment résiduel d’au moins 1 seconde a été complété par des zéros jusqu’à 5 secondes et inclus comme échantillon d’entraînement supplémentaire. Les segments de moins de 1 seconde ont été écartés.
Cette stratégie a considérablement augmenté la taille effective du jeu de données d’entraînement. Les échantillons de tonnerre sont passés de 254 à 1 070, soit une hausse de 321 %, et ceux d’aéronef de 121 à 370, soit une hausse de 206 %. Toutefois, les segments résiduels complétés par des zéros introduisent du silence artificiel dans une partie des échantillons d’entraînement. Dimensions de sortie : (64, 157) par segment.
4.4 Approche 4 : segments de spectrogramme mel, 5 secondes avec répétition en boucle (approche proposée)
La répétition audio en boucle a été proposée comme solution de rechange au remplissage par des zéros pour traiter les segments résiduels. Chaque extrait audio est prolongé jusqu’au multiple de 5 secondes suivant en répétant l’audio depuis le début, puis divisé en segments complets de 5 secondes sans remplissage par des zéros. Formellement, pour un extrait audio d’une longueur de n échantillons : ntarget = ⌈n / nchunk⌉ × nchunk. L’audio répété en boucle est alors donné par tile(a)[:ntarget].
Cette approche garantit que chaque trame de chaque segment d’entraînement contient de l’information audio réelle, éliminant ainsi l’effet de confusion dû au silence artificiel. La segmentation avec répétition en boucle a produit 7 341 segments au total, soit 297 de plus que la segmentation avec remplissage par des zéros, principalement parce que les segments résiduels auparavant trop courts pour constituer des échantillons utiles après remplissage sont désormais prolongés en segments complets. Dimensions de sortie : (64, 157) par segment.

5. Architectures des modèles
Tous les modèles ont été entraînés avec l’optimiseur Adam, un taux d’apprentissage de 1×10⁻³, une fonction de perte d’entropie croisée, une taille de lot de 32 et 16 époques. Les données ont été réparties selon un ratio de 80/10/10 entre les ensembles d’entraînement, de validation et de test par échantillonnage stratifié.
5.1 BC-ResNet (CNN 2D)
L’implémentation de BC-ResNet utilise des convolutions séparables en profondeur adaptées de MobileNet [15] combinées à des connexions résiduelles de raccourci provenant de ResNet [14]. L’architecture traite le spectrogramme mel comme une image 2D présentant une structure spatiale dans les dimensions fréquentielle et temporelle. Trois étapes de sous-échantillonnage augmentent progressivement le nombre de canaux de 16 à 96, suivies d’un regroupement moyen global et d’une tête de classification linéaire.
La convolution séparable en profondeur factorise une convolution standard en une étape par canal, soit un filtre par canal d’entrée, et une étape ponctuelle, soit une convolution 1×1 pour mélanger les canaux. Elle réduit ainsi le nombre de paramètres et le calcul tout en préservant la capacité de représentation. Paramètres : environ 50 000. Entrée : (1, 64, T), image à un seul canal.
5.2 MatchboxNet (CNN 1D)
MatchboxNet traite le spectrogramme en considérant la dimension fréquentielle comme des canaux et la dimension temporelle comme une séquence 1D. Cinq blocs résiduels appliquent des convolutions 1D séparables en profondeur avec des noyaux progressivement plus grands (13, 15, 17, 19, 21), ce qui permet au modèle de capter des motifs temporels à plusieurs échelles. Un prologue et un épilogue utilisant des convolutions dilatées élargissent davantage le champ récepteur.
Cette architecture a été conçue à l’origine pour la détection de mots-clés (Majumdar et Ginsburg, 2020) et convient bien à l’inférence en continu grâce à sa structure de traitement causal. Paramètres : environ 77 000. Entrée : (n_freq, T), avec les fréquences comme canaux.
5.3 GRU (récurrent)
Le modèle GRU traite le spectrogramme comme une séquence temporelle de 157 vecteurs de fréquences, un par pas de temps. Deux couches GRU empilées de 128 unités cachées maintiennent un état caché qui accumule l’information contextuelle au fil de la séquence. L’état caché final est transmis à une tête de classification à deux couches avec régularisation par abandon de neurones.
Contrairement aux architectures CNN, le GRU modélise explicitement les dépendances temporelles grâce à son mécanisme de portes, ce qui permet théoriquement de détecter les sons dont l’identité dépend de l’évolution temporelle plutôt que du contenu spectral instantané. Toutefois, le traitement séquentiel empêche la parallélisation et augmente la latence d’inférence. Paramètres : environ 182 000. Entrée : (T, n_freq), séquence de vecteurs de fréquences.
6. Expériences et résultats
6.1 Protocole expérimental
Dix expériences ont été réalisées en faisant varier le type de caractéristiques, la couverture temporelle, la stratégie de prétraitement et l’architecture du modèle. Toutes ont utilisé la même graine aléatoire (42), la même taille de lot, le même taux d’apprentissage et le même nombre d’époques pour assurer la comparabilité. La classe Feu a été plafonnée avant la répartition des données dans toutes les expériences.
6.2 Résultats globaux
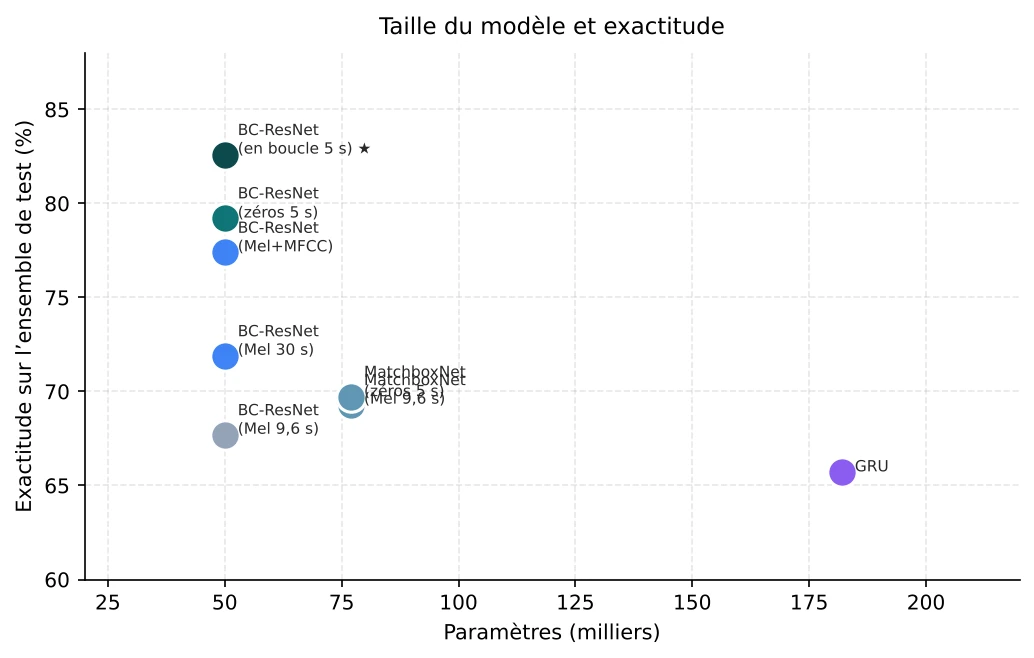
| Exp. | Modèle | Caractéristiques | Couverture | Exactitude sur l’ensemble de test | Rappel du tonnerre | Paramètres |
|---|---|---|---|---|---|---|
| 1 | BC-ResNet | Mel | 9,6 s | 67,7 % | 69 % | Environ 50 000 |
| 2 | MatchboxNet | Mel | 9,6 s | 69,3 % | 97 % | Environ 77 000 |
| 3 | BC-ResNet | Mel+MFCC | 30 s | 77,4 % | 75 % | Environ 50 000 |
| 4 | MatchboxNet | Mel+MFCC | 30 s | 69,5 % | 75 % | Environ 77 000 |
| 5 | BC-ResNet | Mel | 30 s | 71,9 % | 81 % | Environ 50 000 |
| 6 | MatchboxNet | Mel | 30 s | 68,9 % | 69 % | Environ 77 000 |
| 7 | GRU | Segments mel | 5 s | 65,7 % | 82 % | Environ 182 000 |
| 8 | BC-ResNet | Segments mel (remplissage par des zéros) | 5 s | 79,2 % | 93 % | Environ 50 000 |
| 9 | MatchboxNet | Segments mel (remplissage par des zéros) | 5 s | 69,7 % | 85 % | Environ 77 000 |
| 10 ★ | BC-ResNet | Segments mel (répétition en boucle) | 5 s | 82,6 % | 88 % | Environ 50 000 |

6.3 Effet de la stratégie d’extraction de caractéristiques
L’extension de la couverture temporelle de 9,6 à 30 secondes, combinée aux caractéristiques MFCC, a amélioré l’exactitude de BC-ResNet de 9,7 points de pourcentage, passant de 67,7 % à 77,4 %. Cette amélioration est largement attribuable à une meilleure représentation des extraits de tonnerre et de train, dont les durées moyennes, respectivement de 15,5 s et de 13,9 s, dépassent largement la couverture de référence. Les effets de ces deux changements, l’extension de la couverture et l’ajout des MFCC, peuvent être séparés à l’aide de la configuration mel seule de 30 secondes, soit l’expérience 5, à 71,9 %, décrite à la section 4.2 : l’extension de la couverture à elle seule explique 4,2 des 9,7 points (67,7 % → 71,9 %), tandis que l’ajout des MFCC à cette couverture étendue explique les 5,5 points restants (71,9 % → 77,4 %).
L’ajout des MFCC aux caractéristiques de spectrogramme mel a amélioré l’exactitude globale, mais a réduit le rappel du tonnerre de 81 % à 75 % dans la configuration de 30 secondes. Ce compromis concorde avec l’hypothèse selon laquelle la compression MFCC atténue les caractéristiques énergétiques impulsives du tonnerre, mieux préservées dans le spectrogramme mel brut.
6.4 Effet de la stratégie de segmentation
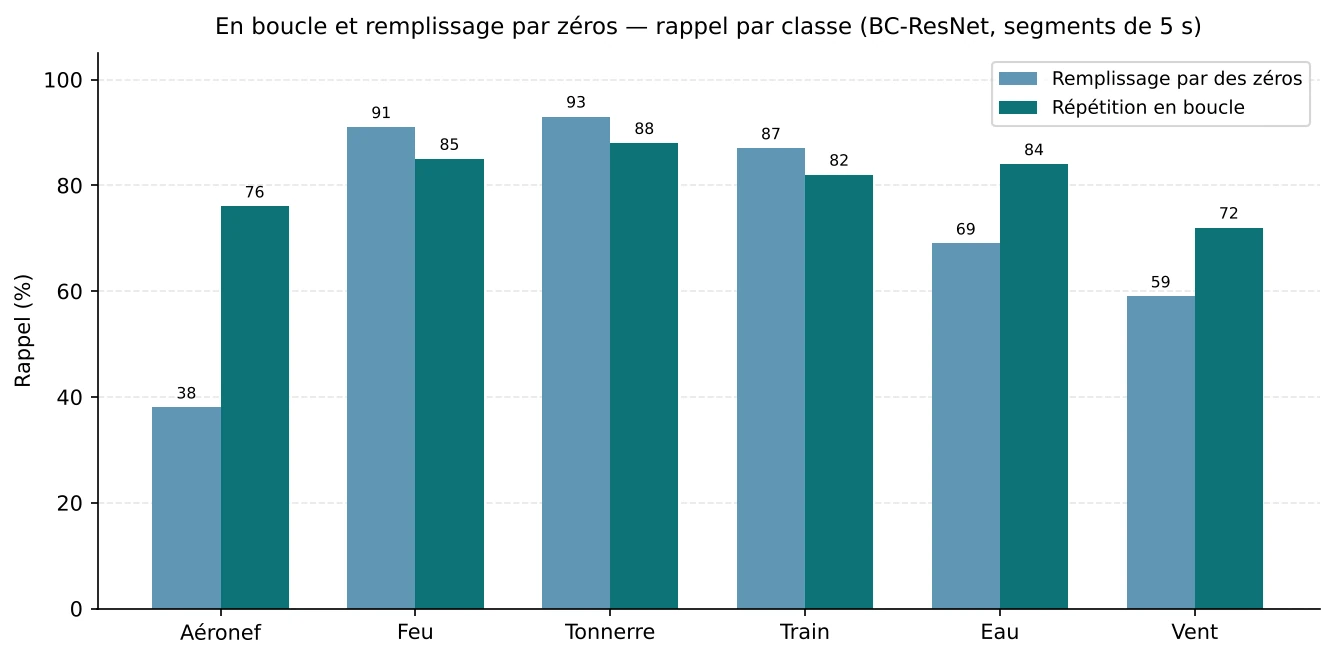
Le passage du remplissage ou de la troncature à durée fixe à la segmentation a produit l’amélioration de performance la plus importante, faisant passer l’exactitude de BC-ResNet de 77,4 % à 79,2 % avec remplissage par des zéros, puis à 82,6 % avec répétition en boucle. Cette dernière a dépassé la segmentation avec remplissage par des zéros de 3,4 points de pourcentage au total, avec des améliorations particulièrement marquées du rappel des classes Aéronef (38 % → 76 %) et Eau (69 % → 84 %). Ce gain net n’est toutefois pas uniforme entre les classes : les rappels des classes Feu (91 % → 85 %), Tonnerre (93 % → 88 %) et Train (87 % → 82 %) ont tous légèrement diminué avec la répétition en boucle par rapport au remplissage par des zéros (figure 6). Comme la détection du tonnerre est la principale motivation de cet article, ce compromis mérite d’être énoncé explicitement plutôt que de n’apparaître que dans la figure : la répétition en boucle réoriente la performance vers les classes aux extraits les plus courts et les plus sous-représentées, au prix d’une baisse modeste pour les classes déjà bien représentées, pour un gain net tant en exactitude globale qu’en performance macro-moyennée.
L’amélioration de la classe Aéronef est particulièrement importante compte tenu de sa petite taille, soit 151 extraits. Les segments résiduels complétés par des zéros des extraits d’aéronef, dont beaucoup durent environ 11 secondes et produisent un résidu de 1 seconde, contenaient une forte proportion de silence qui diluait l’information des échantillons d’entraînement. La répétition en boucle garantit que ces résidus contiennent de l’audio réel répété, améliorant ainsi la qualité et la cohérence des échantillons d’entraînement de cette classe.
6.5 Analyse par classe du meilleur modèle
Rappel par classe du modèle le plus performant : BC-ResNet, segments de 5 s répétés en boucle.
| Classe | Précision | Rappel | F1 | Effectif | VP / FP |
|---|---|---|---|---|---|
| Aéronef | 0,78 | 0,76 | 0,77 | 38 | 29 / 8 |
| Feu | 0,98 | 0,85 | 0,91 | 100 | 85 / 2 |
| Tonnerre | 0,87 | 0,88 | 0,87 | 113 | 99 / 13 |
| Train | 0,83 | 0,82 | 0,82 | 104 | 85 / 17 |
| Eau | 0,76 | 0,84 | 0,80 | 82 | 69 / 22 |
| Vent | 0,66 | 0,72 | 0,69 | 57 | 41 / 21 |
| Macro-moyenne | 0,81 | 0,81 | 0,81 | 494 | — |
Analyse de la confusion pour le tonnerre : VP = 99, FP ≈ 13, FN = 14, VN ≈ 367. Le modèle identifie correctement 88 % des événements de tonnerre avec une précision de 87 %, ce qui indique un faible taux de fausses alertes, une propriété importante pour le déploiement pratique.

6.6 Comparaison des architectures des modèles
BC-ResNet a systématiquement surpassé MatchboxNet en exactitude globale pour toutes les configurations de caractéristiques, atteignant jusqu’à 82,6 %, contre un maximum de 69,7 % pour MatchboxNet. Ce résultat suggère que la structure spatiale 2D des spectrogrammes mel est mieux exploitée par des architectures convolutives 2D que par un traitement temporel 1D.
MatchboxNet a obtenu un rappel du tonnerre remarquablement élevé de 97 % avec les caractéristiques mel de référence de 9,6 secondes, soit le rappel du tonnerre le plus élevé de toutes les expériences. Il a toutefois mal généralisé aux autres classes, avec une exactitude globale de 69,3 %. Ce résultat suggère que le traitement temporel 1D de MatchboxNet saisit efficacement le motif d’attaque impulsive du tonnerre dans les extraits courts, mais éprouve des difficultés avec la tâche de classification plus large.
Le modèle GRU a obtenu des résultats inférieurs à ceux des deux architectures CNN malgré son plus grand nombre de paramètres, avec une exactitude globale de seulement 65,7 %. Le rappel de la classe Vent s’est effondré à 4 % dans une configuration, ce qui suggère que le modèle récurrent n’a pas appris de représentation stable des sons non impulsifs à texture uniforme. Le goulot d’étranglement du traitement séquentiel rend également le GRU inadapté au déploiement en temps réel en périphérie.

7. Discussion
7.1 La répétition audio en boucle comme stratégie de prétraitement
La stratégie proposée de répétition audio en boucle répond à une limite fondamentale du remplissage par des zéros pour la classification d’extraits audio de durée variable : l’introduction de silence artificiel dans les échantillons d’entraînement. Le gain de 3,4 points de pourcentage d’exactitude globale entre la segmentation avec remplissage par des zéros et celle avec répétition en boucle, combiné au quasi-doublement du rappel de la classe Aéronef (38 % → 76 %), constitue une preuve solide que le remplissage par des zéros dégrade sensiblement la performance des modèles pour les classes dont les extraits sont courts ou de durée variable.
L’amélioration est particulièrement marquée pour les classes minoritaires dont une grande proportion de segments contient du remplissage. Pour les extraits d’aéronef d’une durée moyenne de 11,4 secondes, une proportion importante des segments de 5 secondes comprend des résidus largement complétés par des zéros dans l’approche standard. La répétition en boucle transforme ces segments pauvres en information en échantillons d’entraînement entièrement remplis de contenu, augmentant ainsi les données d’entraînement utiles pour cette classe sans nécessiter de nouveaux enregistrements.
7.2 Compromis entre l’exactitude globale et le rappel du tonnerre
Un compromis récurrent a été observé entre l’exactitude globale de classification et le rappel propre au tonnerre dans les expériences. Le rappel du tonnerre le plus élevé, soit 97 %, a été obtenu par MatchboxNet avec des caractéristiques mel de 9,6 secondes, une configuration dont l’exactitude globale n’était que de 69,3 %. La configuration offrant l’exactitude globale la plus élevée, soit BC-ResNet avec des segments répétés en boucle à 82,6 %, a obtenu un rappel du tonnerre de 88 %.
Ce compromis reflète les différentes propriétés acoustiques des classes cibles. L’attaque impulsive distinctive et la structure spectrale du tonnerre le rendent relativement facile à détecter dans des extraits courts avec des caractéristiques simples. À mesure que la complexité du modèle et la diversité des données augmentent, le modèle apprend à équilibrer sa performance entre toutes les classes, ce qui peut légèrement abaisser le plafond de performance d’une classe donnée.
Pour les applications dont l’objectif principal est la détection du tonnerre, comme les systèmes d’alerte à la foudre, MatchboxNet avec des caractéristiques mel de courte durée peut être préférable malgré son exactitude globale inférieure. Pour une surveillance environnementale équilibrée, BC-ResNet avec des segments répétés en boucle constitue la meilleure configuration.
7.3 Limites
Plusieurs limites de ces travaux doivent être reconnues. Premièrement, toutes les expériences ont été réalisées sur des jeux de données préenregistrées dans des conditions contrôlées; un déploiement réel à l’extérieur peut présenter des conditions acoustiques absentes des données d’entraînement, comme le bruit du vent, des sons qui se chevauchent et des distances variables par rapport au microphone. Deuxièmement, la taxonomie à six classes ne couvre pas toute la gamme des sons présents en milieu montagneux. Troisièmement, le système actuel effectue une classification à étiquette unique et ne peut pas détecter plusieurs événements sonores simultanés. Quatrièmement, les dix expériences ont utilisé une seule graine aléatoire (42); les différences rapportées entre les configurations, y compris l’écart de 3,4 points entre la segmentation avec remplissage par des zéros et celle avec répétition en boucle, sur lequel repose la principale recommandation de l’article, n’ont pas été validées par rapport à la variabilité de l’entraînement d’une exécution à l’autre. Répéter chaque configuration avec plusieurs graines et rapporter la dispersion renforcerait ces comparaisons. Cinquièmement, il faut confirmer que la répartition entre les ensembles d’entraînement, de validation et de test pour les configurations segmentées, aux sections 4.3–4.4, a été effectuée au niveau des extraits sources plutôt que des segments. Comme les segments répétés en boucle sont générés à partir d’un même extrait source, une répartition au niveau des segments pourrait permettre à des contenus audio presque identiques de se retrouver à la fois dans l’ensemble d’entraînement et dans l’ensemble de test. Ce risque se concentre précisément dans les extraits courts des classes minoritaires, comme Aéronef et Eau, pour lesquels la répétition en boucle présente les gains rapportés les plus importants.
8. Conclusion
Cet article a présenté un système intégré de surveillance acoustique pour la classification des sons environnementaux sur des appareils en périphérie, axé sur la détection du tonnerre et du feu dans les écosystèmes montagneux. Quatre stratégies d’extraction de caractéristiques ont été évaluées systématiquement. Une nouvelle approche de répétition audio en boucle a montré des avantages mesurables par rapport au remplissage par des zéros pour la performance des classes minoritaires. Trois architectures légères ont été comparées au moyen de dix expériences, et BC-ResNet a systématiquement obtenu la meilleure performance globale. La meilleure configuration, BC-ResNet avec des segments mel de 5 secondes répétés en boucle, a atteint une exactitude globale de 82,6 % sur l’ensemble de test et un rappel du tonnerre de 88 %, avec environ 50 000 paramètres et une latence d’inférence de 50 ms sur un Raspberry Pi 4.
Les résultats montrent qu’une attention particulière au prétraitement audio, à l’équilibrage des classes et au choix de l’architecture peut produire des modèles déployables en périphérie qui rivalisent avec des systèmes plus volumineux, sans infrastructure infonuagique ni matériel à forte consommation d’énergie. La stratégie proposée de répétition audio en boucle est simple à mettre en œuvre et largement applicable aux tâches de classification audio portant sur des extraits de durée variable.
Références
- Piczak, K. J. (2015). Environmental sound classification with convolutional neural networks. IEEE MLSP.
- Salamon, J., & Bello, J. P. (2017). Deep convolutional neural networks and data augmentation for environmental sound classification. IEEE Signal Processing Letters, 24(3), 279–283.
- Mushtaq, Z., & Su, S. F. (2020). Environmental sound classification using a regularized deep convolutional neural network with data augmentation. Applied Acoustics.
- Li, J., Dai, W., Metze, F., Qu, S., & Das, S. (2017). A comparison of deep learning methods for environmental sound detection. arXiv:1703.06902.
- Zhang, X., Zou, Y., & Shi, W. (2017). Dilated convolution neural network with LeakyReLU for environmental sound classification. IEEE.
- Kahl, S., et al. (2021). BirdNET: A deep learning solution for avian diversity monitoring. Ecological Informatics.
- Silva, B., et al. (2022). soundClass: An automatic sound classification tool for biodiversity monitoring using machine learning. Methods in Ecology and Evolution.
- Stowell, D., et al. (2019). Automatic acoustic identification of individuals in multiple species. Journal of the Royal Society Interface.
- Kim, B., Chang, S., Lee, J., & Sung, D. (2021). Broadcasted residual learning for efficient keyword spotting. INTERSPEECH. arXiv:2106.04140.
- Majumdar, S., & Ginsburg, B. (2020). MatchboxNet: 1D time-channel separable convolutional neural network architecture for speech commands recognition. INTERSPEECH. arXiv:2004.08531.
- Rybakov, O., et al. (2020). Streaming keyword spotting on mobile devices. INTERSPEECH.
- Sigtia, S., et al. (2018). Efficient voice trigger detection for low resource hardware. INTERSPEECH.
- Amazon Science (2019). Accurate detection of wake word start and end using a CNN.
- He, K., Zhang, X., Ren, S., & Sun, J. (2016). Deep residual learning for image recognition. CVPR.
- Howard, A. G., et al. (2017). MobileNets: Efficient convolutional neural networks for mobile vision applications. arXiv:1704.04861.
- Choi, S., et al. (2019). Temporal convolution for real-time keyword spotting on mobile devices. INTERSPEECH.
- Phan, H., et al. (2018). Weighted and multi-task loss for rare audio event detection. ISIP.
- Tokozume, Y., & Harada, T. (2017). Learning environmental sounds with end-to-end convolutional neural network. ICASSP.
- Bansal, A., & Garg, N. K. (2022). Environmental sound classification: A descriptive review of the literature. Intelligent Systems with Applications.
- Piczak, K. J. (2015). ESC-50: Dataset for environmental sound classification.
- Fonseca, E., et al. (2020). FSD50K: An open dataset of human-labeled sound events. arXiv:2010.00475.